UNIX 时间戳完全指南:从 1970 到现在
拿 1738368000 这个数来说。知道规则的人一眼就能读出:2025 年 2 月 1 日 00:00:00 UTC。不知道的人看到的是一串噪声。
这就是 Unix 时间的全部设计:一个整数,没有时区,没有日历,没有夏令时,也不需要争论「是哪个 2 月」。 这篇文章余下的内容,都是这句话的推论——包括那个整数最终会用完这件事。
一、一个整数,两种读法
定义只有一句话,但每个词都有分量:
Unix 时间是从 1970 年 1 月 1 日 00:00:00 UTC 起流逝的秒数,不计闰秒。
这句话里塞了四件事。
它从 UTC 的一个固定瞬间起算。 不是从你的本地零点。东京和芝加哥的两个人看同一个时间戳,看到的是同一个数字,然后各自换算成自己那边的墙上时间。
单位是秒。 早期的 Unix 按六十分之一秒计数,那是下一节的故事,但正是它让这个数字显得这么小。
闰秒被排除在外。 这是几乎所有人都会弄错的一点,下面单独用一节讲。
它可以是负数。 1970 年之前的日期就是负值,不是错误状态。-1 就是 1969-12-31 23:59:59 UTC。
同一个瞬间,六种写法。只有后三种带时区,而计算机真正存下来的只有前两种。
| 表示方式 | 值 |
|---|---|
| Unix 秒 | 1738368000 |
| Unix 毫秒 | 1738368000000 |
| ISO 8601,UTC | 2025-02-01T00:00:00Z |
| ISO 8601,UTC+8 | 2025-02-01T08:00:00+08:00 |
| ISO 8601,UTC−5 | 2025-01-31T19:00:00-05:00 |
| RFC 2822 | Sat, 1 Feb 2025 00:00:00 +0000 |
注意:时间戳那一列从头到尾没变,日期那一列变了三次。时间戳不是日期,它是同一条全球时间线上的一个点。 日期是你问「这个点相对于地球上的某一块地方落在哪里」时得到的答案。
二、为什么是 1970,而不是 1971
没有人坐在 1969 年挑了个吉日定下 1970 年 1 月 1 日。这个起点在两年里被改过三次,1970 是它最后偶然停下来的位置。
60 Hz 的麻烦
最早的 Unix 跑在 PDP-11 上。这台机器的系统时钟每秒跳 60 下,因为它要为一个市电频率是 60 Hz 的国家计时。所以最自然的存储方式,就是记下跳了多少下。
问题在于这个计数器只有 32 位。按每秒 60 次算,32 位转一圈需要:
2^32 / 60 秒 = 71,582,788 秒 ≈ 2.26 年
两年零三个月。1972 年 3 月 15 日的第三版《Unix 程序员手册》把这件事写得异常直白:
"The time is stored in 32 bits. This guarantees a crisis every 2.26 years."
(时间用 32 位存储。这保证了每 2.26 年出一次危机。)
两年里换了三个起点
最直接的办法是把起跑线往前推。1971 年 11 月 3 日的第一版手册这样定义:
"the time since 00:00:00, Jan. 1, 1971, measured in sixtieths of a second"
(自 1971 年 1 月 1 日 00:00:00 起的六十分之一秒数。)
四个月后的第三版,起点已经改成了 1972 年 1 月 1 日。半年不到换了两个纪元——计数器用完的速度比他们写文档的速度还快。
真正的解法是停止数「跳」,改成数秒。这一步把余量乘了六十:32 位从 2.26 年变成大约 136 年。单位一换,起点就不必再往前凑了,于是被定为 1970 年 1 月 1 日——按手册自己的说法,是「处理起来方便」,任意挑的。
为什么再也没改过
因为到 1970 年代中期,磁盘上已经有数据了。文件、磁带、inode、备份归档,里面全是「自 1970 年起的秒数」。再改一次起点,等于把全世界 Unix 机器上的每一个文件都悄悄重新解释一遍。
于是这个偶然的选择硬化成了一份接口契约。五十六年过去,地球上每一部手机、每一台服务器、每一个数据库,仍然从那个星期四的早晨开始数。
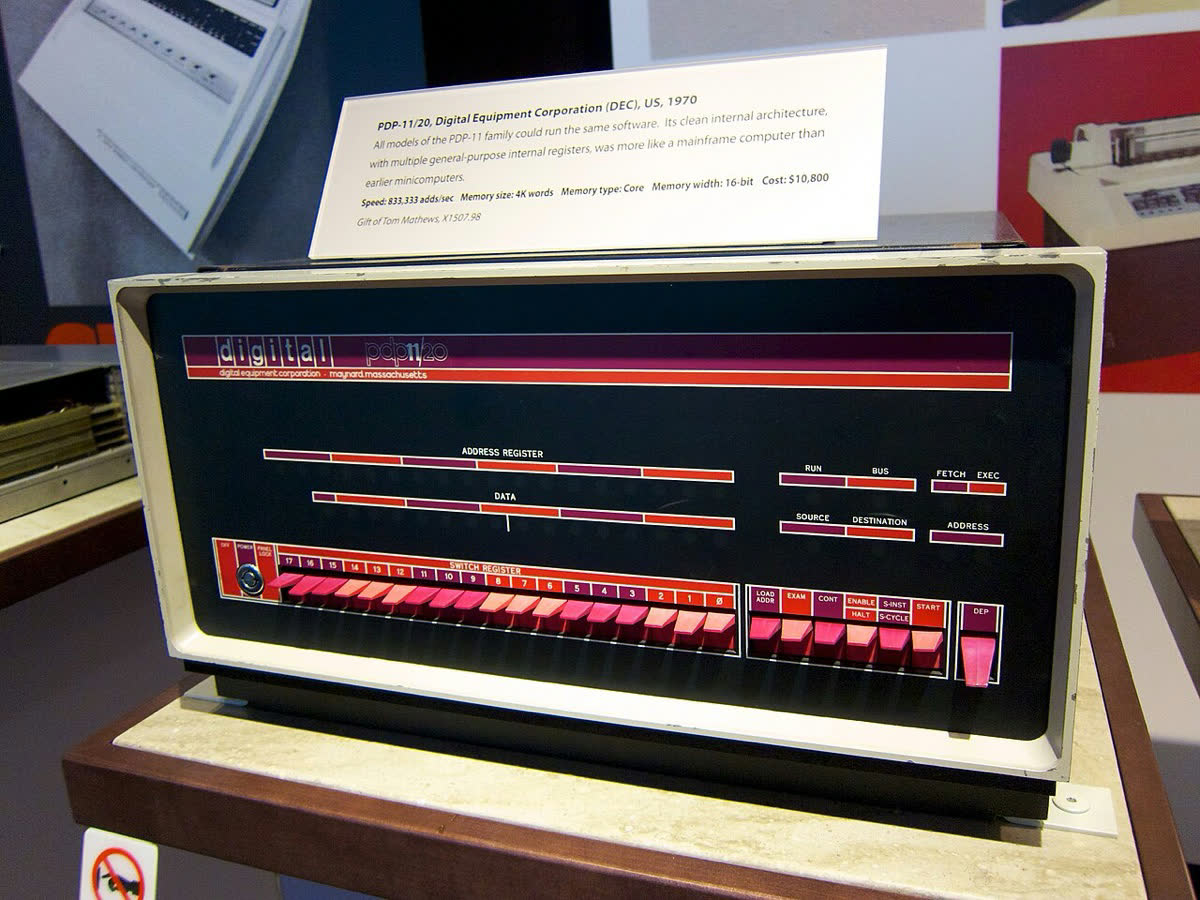
PDP-11/20,Unix 诞生的那个机器系列。展牌上写着「Digital Equipment Corporation (DEC), US, 1970」——和纪元同一年。图片:Don DeBold,CC BY 2.0,来自 Wikimedia Commons
三、每一天都恰好是 86400 秒
从这里开始,Unix 时间不再和物理世界对得上。
地球自转不均匀。它会慢下来,会快一点,会晃。天文学家用 UT1 这个由地球实际姿态导出的时间尺度来跟踪它,而原子钟完全不关心这些。两套尺度会越走越远。
1972 年发明的补丁叫闰秒:每隔一段时间,在 6 月 30 日或 12 月 31 日的最后一分钟插入一个标着 23:59:60 的秒,让原子时和天文时保持在 0.9 秒以内。至今已经加了 27 次,最近一次是 2016 年底。
Unix 时间把它们全部无视。POSIX 标准实际上规定:每一天都恰好 86400 秒,没有例外。所以这个数字不是「物理上流逝了多少秒」,而是盖在真实时间之上的一张理想化、完全均匀的网格上的坐标。
代价是什么
两件事,都很隐蔽。
歧义。 正闰秒发生时,必须有一个 Unix 值被重复使用。1998 年底,915148800 同时指 1998-12-31 23:59:60 和 1999-01-01 00:00:00;2016 年底,1483228800 也是一样。在这一秒里,时间戳不指向唯一瞬间。
一套没人用的平行定义。 有些 Linux 系统跑在 right 配置下,它真的把闰秒算进去,让每天变成 86401 秒。从 1972 年第一次闰秒起,right 时间就领先普通的 posix 时间;到 2017 年,正好领先 27 秒。如果你曾经对比两台机器发现差 27 秒,原因就在这里。
这套机制正在被废掉
2022 年 11 月,第 27 届国际计量大会决定取消闰秒,目标时间 2035 年或更早;2026 年 10 月,第 28 届大会把日期定死——从 2027 年 5 月 20 日起,UTC 连续运行。理由不是漂移停了,而是漂移已经变成工程负担:闰秒搞挂过路由器、搞乱过交易系统,还逼着每家大型软件公司写一段十年才跑几次、因此永远测不充分的特殊代码。
此后 UTC 将被允许离地球自转更远一些,而 Unix 时间会第一次变成真正均匀的秒数计数。
一条实用规则
不要用两个时间戳相减来算时长。
end - start 在两个值之间夹着闰秒时是错的,在系统时钟被 NTP 或用户调整过时也是错的。要算流逝时间,用单调时钟——C 里的 CLOCK_MONOTONIC、浏览器里的 performance.now()、Python 里的 time.monotonic()。它们数的是真实流逝,对上面两个问题都免疫。时间戳用来标记某个瞬间,单调时钟用来测量一段间隔。把两者混用,会得到一年才出现一次、且无法复现的 bug。
四、32 位留下的债
回到那个计数器。
有符号 32 位整数的取值范围是 −2,147,483,648 到 2,147,483,647。套到「1970 年起的秒数」上,就得到一个固定的窗口:
| 边界 | 值 | 日期 |
|---|---|---|
| 最小值 | -2147483648 | 1901-12-13 20:45:52 UTC |
| 纪元 | 0 | 1970-01-01 00:00:00 UTC |
| 最大值 | 2147483647 | 2038-01-19 03:14:07 UTC |
超过最大值的那一秒,值会溢出并绕回最小值。按这种存法,系统会在 2038 年 1 月 19 日 03:14:08 UTC 那一刻,认为现在是 1901 年 12 月 13 日。
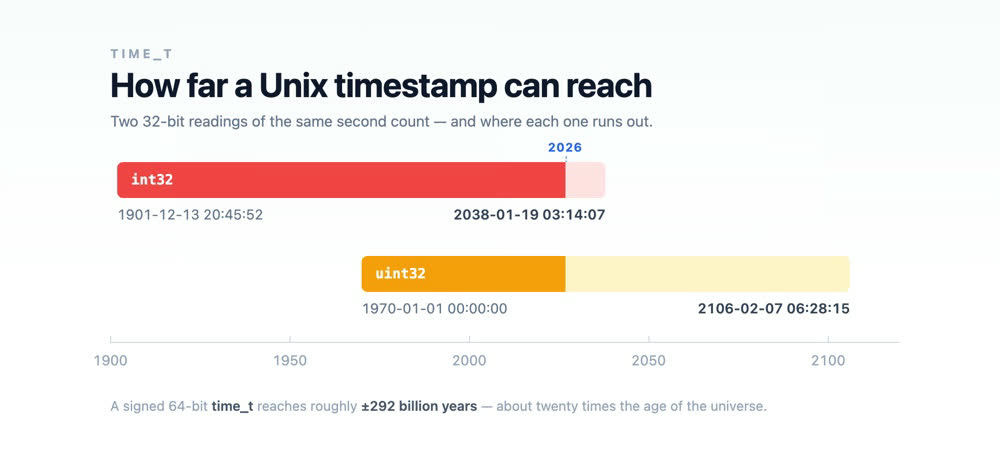
int32 覆盖 1901 到 2038,无符号版本覆盖 1970 到 2106。实心部分是已经用掉的比例。
已经走到哪了
int32 这个窗口总长 136.1 年,2026 年正好落在 91.7% 的位置。这是最容易被低估的一点:2038 问题不是一个遥远的截止日期,而是一根已经填了九成的进度条。
无符号版本能多撑 68 年,到 2106-02-07 06:28:15 UTC。这就是示意图里 uint32 那一行的来历,也是某些格式会「坏两次」的原因。
真正会坏的是哪里
大部分可见的破坏不会发生在操作系统里。Linux 早就换成了 64 位 time_t,主流软件的 64 位构建也都跟上了。风险集中在那些不好改的地方:
- 数据库。 MySQL 的
TIMESTAMP字段就是一个有符号 32 位秒数,止步于 2038-01-19 03:14:07,而且没法原地扩容。DATETIME的范围宽得多,是任何要活过 2038 年的字段的正确选择——但迁移得手动做,每一张表都得查。 - 文件格式。 归档、图片元数据、邮件存储、备份目录里那些 32 位时间戳字段,会在读取它们的机器被换掉很久之后,继续写入绕回去的日期。
- 嵌入式系统。 工业控制器、医疗设备、车机、楼宇自控。这些恰恰是服役二十年、没有升级路径、厂商已经不在了的那一类。
- 32 位用户态。 在老 ARM 板和用旧基础镜像构建的容器里仍然常见。
服务器机柜。2038 年真正会坏的系统,大多比这些更旧、也更不显眼。图片:Carl Lender,CC BY 2.0,来自 Wikimedia Commons
为什么它比千年虫更难缠
千年虫是个格式化问题:截止日期明确,测试方法也明确——把时钟拨过去,看日期对不对。
2038 是个有符号算术问题。溢出不会报错。它会变成一个 1901 年的合法日期,然后继续传播:证书看起来 124 年前就过期了,会话令牌显得古老,排序比较悄悄反了向。
故障会是安静的、局部的,而这是最糟的组合。
五、秒已经不够用了
当计算机最快的一次操作要花毫秒时,秒是够用的。现在不够了。
| 精度 | 典型存储 | 你在哪里遇到它 |
|---|---|---|
| 1 秒 | time_t | 文件系统、数据库、HTTP 头 |
| 1 毫秒 | JavaScript Date、Java Instant | 浏览器、JSON API、Date.now() |
| 1 微秒 | struct timeval | gettimeofday、较老的 C 接口 |
| 1 纳秒 | struct timespec | clock_gettime、APFS、ext4、现代内核 |
这是处理时间戳的代码里最常见的 bug 来源。1738368000 和 1738368000000 是同一时刻的两种单位,而两者看起来都像一个合理的整数。一千倍这个系数,往错的方向乘很容易,靠眼睛发现几乎不可能。
JavaScript 的天花板
JavaScript 的 Date 用双精度浮点数存毫秒。规范把它限制在 ±8.64 × 10¹⁵ 毫秒,也就是 ±1 亿天,约合纪元前后各 273,790 年。这个范围远远超过 int32 的窗口——JavaScript 从来就没有 2038 问题。但毫秒这个单位,正是那么多 API 返回十三位数字、以及 Date.now() / 1000 这行代码如此眼熟的原因。
自带时间的标识符
现代系统越来越多地把时间戳塞进 ID 本身,于是精度选择从实现细节变成了设计决策。UUIDv7 把 48 位毫秒放在开头,从 1970 年起能覆盖约 8900 年,同时让 ID 天然按创建时间可排序。Snowflake 这类 ID 用 41 位毫秒做同样的事,代价是范围只剩几十年。
一个值得单独点名的坑
永远不要把时间戳存进 float32,在毫秒量级上也要小心 float64。32 位浮点只有 24 位尾数;在当前时间戳这个数量级上,它只能分辨约 128 秒的步长。值不是错的,是被取整了——这更糟,因为看上去一切正常,直到相隔一分钟的两个事件拿到同一个时间戳。
六、实际会出错的七种方式
以下这些是真正会出现在 bug 列表里的,大致按出现频率排序。
1. 是秒还是毫秒? 数字到手,光看位数判断不了,选错就把日期扔到 1970 年或者公元 57000 年。快速自查:当前时间戳的秒值大约是 10 位,毫秒值是 13 位。
2. 本地时间不是时间戳。 date -d @0 打印的不是 1970-01-01 00:00:00,而是把 UTC 零点换算到你的时区——在中国是 1970-01-01 08:00:00,在纽约是 1969-12-31 19:00:00。数字是同一个,渲染是局部的。
3. 时间戳里没有时区。 这不是 Unix 时间的缺陷,恰恰是它的目的。但它意味着不带时区的「2025-02-01 00:00:00」不构成一个瞬间,任何存这种字符串的系统,迟早会和另一个系统对它指代什么产生分歧。
4. 按文本排序时间戳会在位数边界崩掉。 2001 年 9 月 9 日 1000000000 到来时,所有按字符串而不是数字比较时间戳的软件,都开始把新数据排到旧数据前面——因为 "999999999" 排在 "1000000000" 后面。补零或者存整数能解决,别的办法都不行。
5. MySQL 的 TIMESTAMP。 上面说过,但值得单独列一条,因为它是普通 Web 应用里最常见的 2038 暴露点。
6. 1970 年之前。 负值合法,但经常被校验器、数据库字段类型和假定「时间戳 = 正整数」的 API schema 拒绝。出生日期、历史记录、天文数据,全都落在纪元的另一侧。
7. 拿墙上时钟相减。 前面提过,这里再列一次,因为它是那种会产生间歇性、无法复现的线上故障的写法。算时长请用单调时钟。
七、人们会庆祝的那些时间戳
Unix 时间有一点点「整数癖」文化。下面这些是会被注意到的几个。
| 时间戳 | 日期(UTC) | 为什么值得一提 |
|---|---|---|
0 | 1970-01-01 00:00:00 | 纪元本身 |
−1 | 1969-12-31 23:59:59 | 证明范围可以向过去延伸 |
119731017 | 1973-10-17 18:36:57 | 第一个被当作自描述引用的时间戳 |
1000000000 | 2001-09-09 01:46:40 | 第一个十位时间戳,字符串排序在此断裂 |
1073741824 | 2004-01-10 13:37:04 | 2³⁰,那个「1337」时间戳 |
1234567890 | 2009-02-13 23:31:30 | Google 为它做了个涂鸦 |
2147483647 | 2038-01-19 03:14:07 | 最后一个可表示的秒 |
4294967295 | 2106-02-07 06:28:15 | 无符号版本的上限 |
2001 年那次最有意思,因为它就是 2038 的微缩预演:一个完全合法的数字,所有系统都接受了它,然后一次比较悄悄错掉了。
八、2038 之后
解法并不复杂。有符号 64 位 time_t 前后各能覆盖约 2920 亿年——大约是宇宙年龄的二十倍。后面不会再有第二个 2038,也不会有任何现实的软件系统需要再考虑这个上限。
几乎所有当前的 64 位平台都已经完成了切换。剩下的工作不在内核里,而在数据库、文件格式、固件和那些服役了二十年的设备里。
另外两个翻转日
还有两个日期值得知道,它们没那么有名,但同样真实。
2036-02-07 06:28:16 UTC —— NTP 第 0 纪元结束。 网络时间协议从 1900 年 1 月 1 日起、用无符号 32 位字段数秒。它会在 2036 年用完,而且和 Unix 的情况不同:不破坏报文格式就没有加宽的余地。协议本身定义了扩展机制,但它要求两端都升级——对 NTP 来说,这意味着每一台曾经被配置过对时的设备。
2106-02-07 —— 无符号 32 位的天花板。 任何用 uint32 而不是 int32 存秒的格式,都多拿到 68 年。有些文件格式和嵌入式协议正是这么做的,这也是示意图里为什么有两根条而不是一根。
该做什么
如果你维护的系统 2038 年还在跑:
- 排查每一处用定宽整数存时间戳的地方,以及每一个
TIMESTAMP类型的字段。 - 长生命周期的数据,优先用
DATETIME、64 位整数或 ISO 8601 字符串。 - 写一个把系统时钟拨到 2038-01-19 之后、然后跑完整读写链路的测试。这个测试很便宜,而几乎没有人写。
- 把任何基于字符串的时间戳比较当成潜在 bug,而不是代码风格问题。
结语:1970 是一个决定
1738368000 这个数字看起来像一条关于宇宙的事实。它不是。它是 1971 年决定数时钟跳数、1972 年决定改数秒、以及在「每两年挪一次起点」彻底行不通之后随手挑的一条起跑线,三者叠出来的结果。
五十六年后,这个选择嵌进了每一个文件系统、每一个数据库、每一行日志和互联网上每一个 API。它会比做出它的人活得久,比它诞生时的机器活得久,大概也会比那个为了补同一个底层问题而发明的闰秒活得久。
这件事有一种让人清醒的力量:时间戳不是时间,它是一份约定——一份非常好的约定,精确到足够有用,简单到能塞进一个整数——而和所有约定一样,它有来历、有保质期、也有维护成本。
知道这个数字从哪来,你才能一眼判断:一个值是秒还是毫秒,一个日期是 UTC 还是本地,以及眼前这套系统在 2038 年会不会出事。
需要查某个具体值?时间戳转换器 支持秒、毫秒与 ISO 8601 的双向换算,带时区处理——手上有一个数字却不知道它是哪个单位时,最好用。